
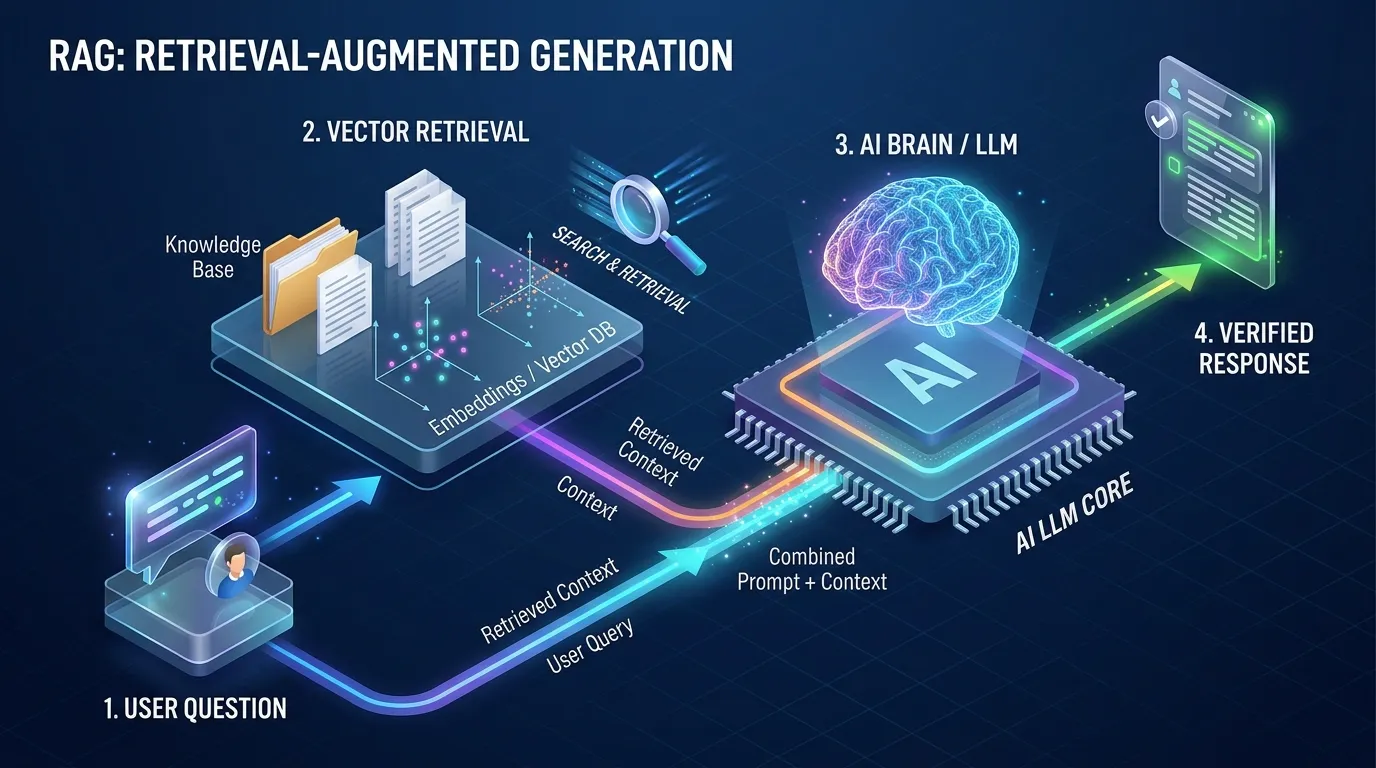
A Do Follow nasceu de projetos freela e hoje soma mais de 20 clientes em setores como beleza, skincare, marketing, seguros e turismo em todo o Brasil. A equipe baseia seus conteúdos em fontes verificáveis com a técnica de Geração Aumentada por Recuperação (RAG).
O método conecta grandes modelos de linguagem (LLMs) a uma base de conhecimento selecionada. O processo extrai trechos para citação, evitando informações inventadas. A recuperação transforma perguntas em Embeddings, armazena esses vetores em bancos de dados e, em seguida, realiza uma Busca Semântica para identificar o texto mais relevante para o modelo.
No Brasil, esse jeito é chamado de Geração Aumentada por Recuperação. RAG depende de fontes atuais e bem indexadas, ajuda a reduzir as Alucinações, mas não elimina todos os erros. Falhas acontecem quando vetores ficam desatualizados ou prompts são mal feitos.
Ferramentas de orquestração, como LangChain e LlamaIndex, conectam-se a provedores como OpenAI, Google e Meta. Elas realizam a criação de embeddings e inferência na AWS ou Google Cloud, utilizando modelos de embeddings e a arquitetura Transformer. Ajustes finos (fine-tuning) e engenharia de prompts também são aplicados. A integração das respostas com Knowledge Graphs ou uma Base de Conhecimento organizada oferece uma camada adicional de segurança e precisão no uso prático.
Desvendando o RAG: a ponte entre LLMs e seu conhecimento específico
O que são Modelos de Linguagem Grandes (LLMs) e seus desafios atuais?
LLMs geram textos bem estruturados, mas não garantem precisão em fatos específicos ou atuais. Isso abre margens para erros na produção. Modelos de Linguagem Grandes (LLMs) funcionam com base na Arquitetura Transformer, prevendo palavras pela análise dos padrões presentes nos dados de treinamento.
Eles se destacam no estilo e conseguem resumir ideias complexas. Contudo, falham ao tentar informar sobre o SKU de um produto lançado na semana passada ou a política interna mais recente da empresa.
Dois problemas são cruciais para equipes de SEO: os modelos param de aprender após um corte nos dados de treinamento, e respostas baseadas apenas em probabilidade inventam detalhes, resultando nas conhecidas Alucinações (IA). Para criadores de conteúdo, isso pode gerar um dado técnico convincente, mas totalmente equivocado, que acaba no texto final. A razão é simples: o modelo não consulta diretamente uma fonte oficial ao responder.
Como o RAG aprimora a capacidade dos LLMs?
A ideia principal: o Retrieval Augmented Generation coloca uma etapa extra de busca, apoiando as respostas em fatos reais e não só na “memória” do modelo. Assim fica mais fácil trazer informações corretas, sem precisar treinar novamente o modelo inteiro.
No dia a dia, o processo geralmente segue três etapas objetivas:
- Embedding da pergunta: sua dúvida se transforma em um vetor por meio de um modelo de embeddings. Normalmente se usa uma ferramenta de embeddings baseada em texto rodando na AWS ou Google Cloud.
- Busca semântica: esse vetor é comparado dentro de um banco vetorial. Ele recorre à Busca Semântica para localizar os melhores trechos dentro da sua Base de Conhecimento.
- Geração aumentada: os trechos selecionados vão para o prompt junto com a pergunta original; tudo isso alimenta o LLM. Agora a resposta pode trazer fontes ou citações exatas.
No e-commerce, por exemplo, é possível extrair diretamente do banco o texto da garantia oficial e solicitar ao modelo que o adapte para uma página de Perguntas Frequentes (FAQ). O resultado respeita os dados reais e indica a origem, reduzindo o trabalho manual posterior e os riscos para o SEO.
Diversos orquestradores conectam sua escolha de provedor (OpenAI, Google, Meta) com camadas internas que fazem toda busca acontecer por trás dos bastidores. Cuidam das embeddings e do ranqueamento no automático. Só que ainda depende muito do Prompt Engineering; se você estrutura mal os trechos recuperados, até bons conteúdos acabam fora da resposta final do modelo.
A diferença determinante: RAG vs. Fine‑tuning tradicional
Muda onde as coisas acontecem: no RAG você atualiza os dados enviados ao modelo; no fine-tuning altera pesos internos dele mesmo. Essa decisão define pontos críticos quando se escolhe como abordar cada projeto.
No fine-tuning tradicional, surge um modelo personalizado treinado especificamente com seu próprio conjunto de dados. Vale a pena onde velocidade é prioridade ou quando consistência absoluta é exigida em muitos resultados seguidos. Só que manter isso exige manutenção constante, coletar novos dados sempre que algo muda custa caro tanto em computação quanto em tempo dedicado.
No RAG nem precisa re-treinar nada. Basta atualizar informações na Base de Conhecimento, renovar as embeddings e pronto: novidades aparecem nas respostas imediatamente. Para equipes produzindo conteúdo todos os dias ou lidando com atendimento ao cliente, geralmente sai mais rápido e barato usar RAG do que ficar ajustando modelos toda hora.
Só tem uma questão importante: a qualidade das buscas determina quão bom será o resultado final num fluxo RAG. Embeddings ruins ou um banco desorganizado vão entregar amostras erradas, até mesmo LLMs avançados podem ser enganados se receberem informação ruim como referência válida. Muita equipe esquece disso e culpa logo o modelo quando deveria corrigir primeiro as buscas internas.
No Brasil? Comece juntando técnicas robustas de busca semântica com prompts claros mostrando citações; deixe o fine‑tuning só para cenários realmente grandes onde latência baixa ou exigências legais restritas peçam algo fixo embutido desde sempre no sistema. Ferramentas como LangChain e LlamaIndex permitem testar gastando pouco dinheiro (menos que muitos cursos online), mas quem garante qualidade mesmo é sempre ter fontes confiáveis conectadas à busca desde cedo.
Aplicações práticas do RAG: da eficiência ao diferencial competitivo
O Retrieval Augmented Generation traz respostas mais rápidas e embasadas para o marketing. O achismo diminui, e a equipe publica dados ou atende clientes com tranquilidade. Não é preciso checar tudo manualmente depois. Os ciclos de produção ficam ágeis sem retrabalhar o modelo principal.
RAG para chatbots e assistentes virtuais mais inteligentes
Os bots deixam de seguir só roteiros quando buscam referências exatas da base interna em tempo real. Ao unir um modelo de linguagem extenso com uma camada forte de busca semântica, as respostas passam a citar fontes, reduzindo erros nos detalhes.
A dinâmica não tem segredo: transforme políticas, garantias e FAQs em embeddings de texto. Guarde esses vetores numa base específica. Quando surge uma dúvida, traga os três trechos mais relevantes para dentro do prompt. Isso costuma elevar bastante a qualidade das respostas.
As resoluções ficam mais rápidas, com menos repasses, porque as informações já apontam para material original. A ressalva é o tempo de resposta, cada busca acrescenta milissegundos, o que faz diferença em centrais cheias.
Otimização de SEO com geração de conteúdo factual e relevante
A área de conteúdo passa a garantir precisão em larga escala. Em vez de confiar no que o modelo “acha”, os redatores deixam o sistema sugerir textos com trechos retirados do acervo e citações claras nos metadados ou no próprio conteúdo.
- Crie agrupamentos temáticos usando sua base própria e marque trechos por intenção e data; assim evita informação ultrapassada
- Use os textos buscados para montar FAQ schema e respostas destacadas bem próximas do que está no seu material origem
- Agende reprocessos dos embeddings após grandes mudanças para manter resultados atualizados nas buscas
Efeito fácil de medir? Quase não há correção urgente depois da publicação. Os editores poupam tempo revisando preços ou termos jurídicos já que os rascunhos apontam direto às fontes oficiais automaticamente.
Só lembre: quanto maior sua base ou quanto mais reatualizar embeddings, maior pode ficar o custo computacional (e na nuvem nada sai barato). Cada equipe precisa equilibrar frescor dos dados versus gasto com servidor.
Análise de mercado e pesquisa de dados com precisão inédita
O RAG permite extrair insights tanto de relatórios internos quanto documentos públicos sem empilhar PDFs inteiros nos prompts. As conclusões ligam cada afirmação ao parágrafo original, facilitando checagem rápida pelo analista.
Perguntas podem envolver apresentações comerciais, dossiês concorrentes ou gravações, chega um resumo destacando falas principais e suas origens reais. Isso agiliza acompanhamento da concorrência e minimiza erro comparado à revisão manual.
Cuidado básico: a busca nunca será melhor que a qualidade do seu índice. Embeddings desatualizados ou uma base bagunçada geram respostas “convictas” mas erradas, tal qual modelos generativos livres acabam inventando fatos indesejados pela edição. Previna dor de cabeça: agende atualizações frequentes das embeddings e seja rigoroso nas regras dos metadados se quiser confiar nas análises.
Construindo seu sistema RAG: componentes e tecnologias essenciais
Três peças formam o núcleo de um pipeline com busca aumentada por recuperação: vetores bem construídos, um índice pensado para consulta eficiente e prompts exigentes que pedem comprovação. Acertando nesses pontos, as chances de erro factual caem. Se faltar cuidado, o sistema pode espalhar informação errada rapidamente.
A importância dos Embeddings e dos Bancos de Vetores na busca semântica
A qualidade dos vetores determina o desempenho da busca. Se o codificador do modelo posiciona dados sem relação próximos no espaço vetorial, a busca trará contexto ruim. O gerador pode acabar apresentando dados inventados com toda convicção, uma das principais causas das alucinações.
Dois fatores pesam mais no resultado: como dividir os textos em blocos e onde guardar esses vetores. O tamanho do bloco precisa casar com o uso, perguntas rápidas pedem trechos curtos; resumos pedem pedaços maiores. Metadados detalhados, como datas ou nomes de seções, permitem ao sistema priorizar fontes recentes ou confiáveis depois.
- Divisão: corte os documentos em partes relevantes; guarde títulos quando der
- Metadados: acrescente informações sobre origem, horários e intenção a cada vetor
- Frequência de atualização: re-embede sempre que houver mudança; refaça todo o índice após alterações grandes
- Limiares de similaridade: ajuste usando consultas testes fora do treinamento; mude conforme precisão e cobertura nos resultados
Ferramentas como LangChain e LlamaIndex para orquestrar o RAG
Biblitecas desse tipo cuidam do básico, entrada de dados, chamadas para codificação, indexação, buscas, reordenação dos resultados e modelos prontos para prompt. Encare a orquestração como mecanismos que organizam tudo; elas economizam tempo na engenharia mas dependem diretamente da qualidade dos insumos.
Cobre flexibilidade nos conectores da sua ferramenta além de cache inteligente, registro do padrão dos acessos e regras claras de novas tentativas. Troque provedores só mudando os conectores; reduza custos reutilizando codificações em perguntas repetidas. Acompanhar fluxos ajuda a flagrar problemas antes que alguém perceba.
- Percurso clássico: entra dado → codifica → inclui no índice → recupera informação → reordena → gera resposta → checa acurácia
- Monitoramento: avalie quantas vezes respostas relevantes são achadas; observe gasto de tokens; compare respostas humanas usando lógica top-k
- Controle de custo: agrupe tarefas na codificação por lote; atualize apenas partes modificadas do índice para economizar recurso em nuvem
O papel do Prompt Engineering na otimização das respostas
A planilha de prompt serve como real filtro na resposta final. Um template objetivo pode exigir citação das fontes, ou obrigar o modelo a confessar dúvida, cortando erros cheios de certeza injustificada. Configure modelos com baixa aleatoriedade e peça explicitamente pelas fontes para aumentar confiança nas saídas.
Caso precisão seja questão chave, divida em duas fases: mostre primeiros textos recuperados forçando o modelo a justificar as respostas com base neles; depois rode uma nova etapa onde outro verificador passa fato por fato nesses mesmos trechos para descobrir erros que ninguém quer ver indo ao ar.
- Estrutura do template: coloque os trechos principais logo no início; explique claramente as tarefas; exija prova explícita no formato final da resposta
- Padrão esperado: faça os modelos indicarem todas as fontes (URL junto com número do parágrafo); instrua também para apontar brevemente grau de confiança
- Solução alternativa: peça ao modelo dizer “nenhuma fonte confiável” se não houver evidência suficiente em vez de criar respostas falsas
Teste os prompts sempre, use perguntas reais dos usuários e ajuste após cada rodada. Mexer na ordem ou incluir exemplos concretos geralmente reduz mais falhas que trocar só o modelo faz. Guarde cuidadosamente logs detalhados contendo prompt usado, material recuperado e resposta gerada, principalmente nos casos críticos, pois esse histórico mostra rápido onde ocorreu desvio ou erro.
O futuro do RAG no ecossistema de IA e SEO no Brasil
Equipes de SEO no Brasil estão migrando para fluxos baseados em recuperação conforme os modelos fundacionais evoluem. Ganha espaço o conteúdo verificável, atualizado e bem referenciado. Duas tendências impulsionam esse movimento: os modelos processam volumes bem maiores de contexto e sistemas de geração vêm integrados a mecanismos robustos de busca.
Avanços em Modelos Fundacionais e como o RAG se beneficia
Modelos fundacionais recentes suportam muito mais contexto e já entendem informações recuperadas do banco. Um LLM consegue lidar com trechos longos, sem exigir resumos drásticos. Editores podem jogar extratos extensos das bases de conhecimento mantendo as respostas ancoradas nos fatos.
Essa combinação, junto com modelos de embeddings confiáveis e indexação vetorial eficiente, diminui drasticamente respostas infladas ou incorretas (Alucinações), que prejudicam a confiança em SEO, ficam cada vez mais raras. O trabalho se concentra em checar casos isolados, não refazer textos inteiros.
RAG e a democratização do acesso à informação qualificada
Custo menor de computação e softwares abertos permitem que agências fora dos grandes centros mantenham fluxos eficientes de recuperação. Até equipes pequenas conseguem conectar bases próprias, rodar buscas semânticas e alimentar os modelos, sem precisar desenvolver tudo do zero.
- Mantenha uma base de conhecimento pesquisável e transparente, com fontes datadas para garantir respostas sempre atualizadas
- Programe re-embedding frequente após cada atualização para evitar descompasso entre conteúdo novo e resultados antigos
- Ponha a checagem de citações na revisão editorial: qualquer resposta sem link direto para fonte deve ser sinalizada
No dia a dia, isso aparece assim: agências menores passam a manter vários índices por cliente ao invés de treinar modelos toda hora. Conteúdo revisado em português chega rápido ao público local, sem custos proibitivos com fine-tuning.
O diferencial da Do Follow na aplicação estratégica do RAG
A Do Follow dá aos editores mais controle sobre o resgate das informações, nunca trata só como automação. A agência trabalha com grafos curados e busca semântica para garantir que todo dado ou valor tenha fonte direta citada nos próprios textos. Diminui retrabalho jurídico ou mudança forçada nos preços.
A estrutura usa quatro pilares: Base de Conhecimento cuidadosamente montada; agendamento regular das atualizações dos embeddings; ferramentas orquestradoras como as acima; prompts exigindo sempre comprovação das fontes. Isso mantém o conteúdo alinhado tanto às regras internas quanto às políticas dos clientes, e ainda acelera a publicação.
Ainda há risco real ligado a conformidade e fornecedores externos. As exigências da LGPD pedem avaliação jurídica desde cedo, especialmente para separar dados pessoais do processamento externo, evitar ficar preso num único provedor também faz diferença.
